Data Engineering & Analytics Services
VERLÄSSLICHE DATEN

Data Engineering
& Analytics

Machen Sie aus fragmentierten Geschäftsdaten verlässliche Pipelines, Plattformen und Erkenntnisse.

17+
Geschäftstätigkeit in Jahren
100%
In Schweizer Besitz
40+
Langjährige Kunden
650+
Mitarbeiter
80+
Dedizierte Teams

Bauen Sie Cloud-Datenplattformen, Pipelines, Echtzeitverarbeitung und Analytics auf AWS, Azure, Databricks, Snowflake und BigQuery. Die Data-Engineering-Leistungen und Data-Analytics-Lösungen von Axon Active kommen aus einer Hand – von derselben Engineering-Organisation, die seit 2009 für über 40 Unternehmen produktive Software ausgeliefert hat. Verlässliche Pipelines, Cloud-Warehouses und Analytics unter klarer Governance: Jede Zahl lässt sich bis zu ihrer Quelle zurückverfolgen.

Fähigkeiten

Data Engineering & Analytics – unsere Leistungen

Sechs Fähigkeitsbereiche über den modernen Data Stack hinweg – von Pipeline-Engineering und Cloud-Warehouses bis zu Analytics, Governance und Modernisierung. Unsere Data-Engineering-Leistungen erbringt ein festes Team: Die Engineers, die Ihre Plattform bauen, betreiben sie auch.

Pipeline-Engineering: ETL, Datenintegration, Streaming

Skalierbare Batch- und Echtzeit-Pipelines, die CRMs, ERPs, Datenbanken, APIs und Drittplattformen mit Cloud-Warehouses verbinden. Unsere Datenintegration führt fragmentierte Quellen zusammen, die ETL-Entwicklung übernimmt Extraktion, Transformation und Laden im Produktionsmassstab, und die Pipeline-Entwicklung deckt CDC, Streaming, Orchestrierung und Monitoring ab.

Pipeline-Engineering: ETL, Datenintegration, Streaming

Cloud Data Warehousing & Lakehouse-Architektur

Wir entwerfen und betreiben Cloud Data Warehouses und Lakehouse-Architekturen, die mit Datenvolumen und Parallelität mitwachsen. Bewährte Produktionsmuster: Medallion-Lakehouse auf Databricks + Delta Lake, Snowflake-Warehouse-Sizing für Kosten und Performance sowie BigQuery-Slot-Reservierungen mit Materialized Views. Das Schema-Design deckt Mandantenfähigkeit, Datenresidenz und regulierte Workloads ab – gesteuert über Unity Catalog oder ein gleichwertiges Werkzeug.

Python, SQL, PySpark, Kafka, Airflow, dbt, SQLMesh, Databricks, Snowflake, BigQuery, AWS, Azure, Docker, Terraform, Git, CI/CD.

Cloud Data Warehousing & Lakehouse-Architektur

Orchestrierung & Transformation

Verlässliche, skalierbare Daten-Workflows über AWS, Azure, Databricks, Snowflake und BigQuery hinweg – Orchestrierung, Transformations-Pipelines, Scheduling, CI/CD, Monitoring und Lineage-Tracking für produktive Datenumgebungen.

Airflow, Dagster, Prefect, dbt, SQLMesh.

Orchestrierung & Transformation

BI & Analytics Layer

Moderne Data-Analytics-Lösungen: Design des Semantic Layer, Entwicklung von KPI-Dashboards und Self-Service-Analytics für schnellere, verlässlichere Geschäftsentscheidungen.

Looker, Tableau, Power BI, Metabase, Cube, LookML, dbt Metrics.

BI & Analytics Layer

Data Governance: Qualität, Lineage, Observability

Verlässliche, belastbare Daten durch moderne Governance, Tests und Monitoring. Unsere Data-Management-Leistungen umfassen Datenqualitätsprüfungen, Lineage-Tracking, Observability, Audit-Trails und regelkonformen Umgang mit Daten in Unternehmens- und regulierten Umgebungen.

Great Expectations, dbt tests, OpenLineage, Marquez, Monte Carlo, Datadog.

Data Governance: Qualität, Lineage, Observability

Datenmigration & Modernisierung

Unsere Datenmigrations-Leistungen verlagern On-Premise-Warehouses in Cloud-Lakehouses, refaktorieren brüchige ETL-Strecken und konsolidieren fragmentierte Plattformen mit minimaler Unterbrechung. Eine Parallel-Run-Validierung stellt sicher, dass der Cutover das Reporting nicht bricht. Ob von SAP oder Oracle zu Snowflake oder Databricks: Migrationen richten sich nach Ihrem Audit-Kalender, nicht nach unserem.

AWS, Azure, GCP, Databricks, Snowflake, BigQuery, Redshift, dbt, Airflow.

Datenmigration & Modernisierung
Die Disziplinen

Data Engineering & Analytics – von der Infrastruktur zur Erkenntnis

Zwei Disziplinen, die einander ergänzen und aus Rohdaten einen Geschäftsvorteil machen: Engineering baut die verlässlichen Pipelines darunter, Analytics macht aus den Daten darüber klare Entscheidungen. Zusammen laufen sie als durchgängige Data-Management-Leistungen – ein Team verantwortet den Weg vom Quellsystem bis zum Dashboard der Geschäftsleitung.

Data Engineering

Die Infrastruktur hinter verlässlichen Geschäftsdaten bauen und betreiben.

  • Verbindet Daten aus unterschiedlichen Systemen, bereinigt und standardisiert sie, überführt sie in ein verlässliches Warehouse (Snowflake, BigQuery, Databricks) und macht sie für Reporting, Analytics, Automatisierung und Entscheidungen verfügbar.
  • Anders als BI-Beratung hören unsere Data-Engineering-Leistungen nicht beim Dashboard auf – sie lösen die Pipelines, Qualitätsprüfungen, Lineage, das Monitoring und die Audit-Trails darunter. Audit-fähig von Anfang an: produktionsreife Pipelines, die durch Audits, Reporting-Zyklen und Personalwechsel hinweg verlässlich bleiben.
  • Daten entwickeln sich vom internen Reporting zur zentralen Produktfähigkeit. Verlässliche Infrastruktur – Lineage, Governance, Audit-Trails – macht diesen Wandel möglich; Engineering-Disziplin macht ihn dauerhaft.

Data Analytics

Aus verlässlichen Daten Geschäftserkenntnisse machen

  • Hilft Teams zu verstehen, was passiert, warum es passiert und was als Nächstes zu tun ist – Dashboards, KPIs, Trends und klare Empfehlungen für Führung und Fachbereiche.
  • Anders als Data Engineering richtet sich Analytics auf die Geschäftsfragen darüber: Umsatz, Kundenverhalten, Betrieb, Marketing-Performance, Risiko und Wachstumschancen.
  • Gute Analytics ist mehr als Diagramme: Sie beruhen auf klaren Kennzahlendefinitionen, verlässlichen Quellen und Dashboards, die Entscheidungsträger tatsächlich nutzen. Das ist der Unterschied zwischen einem weiteren Report und einer Zahl, die eine Entscheidung verändert.
  • Belastbar von Anfang an: konsistente, erklärbare, nachvollziehbare Zahlen, auf die sich Teams durch Reporting-Zyklen, Audits und Management-Reviews hinweg verlassen können.

Engineering ist nur die halbe Geschichte. Unsere Data-Analytics-Lösungen setzen auf Pipelines unter klarer Governance auf – Finanzen, Marketing, Risiko und Betrieb lesen dieselben Zahlen. Und weil der Analytics-Layer an Quellen mit Lineage-Tracking hängt, lässt sich jede Zahl bis zu ihrem Ursprung zurückverfolgen. Wer Anbieter vergleicht, findet genau in dieser prüfbaren Verbindung vom Dashboard bis zum Quellsystem den eigentlichen Unterschied.

Wie wir arbeiten

Unsere Standards für Data Engineering & Analytics

Drei Standards, die Daten für das Geschäft nutzbar machen – verlässlich genug für Entscheidungen, rückverfolgbar bis zum Quellsystem, konsistent über Teams hinweg, aktuell genug zum Handeln.

Unsere Standards für Data Engineering & Analytics
  1. Verlässlich – bei jeder Transformation getestet

    Schema-Contracts werden bei Source → Staging → Marts durchgesetzt; Great Expectations und dbt-Tests laufen bei jedem Durchlauf; Aktualität, Volumen und Verteilung werden laufend mit Monte Carlo oder einem gleichwertigen Werkzeug überwacht. Bricht die Qualität, werden nachgelagerte Verbraucher gestoppt, bevor falsche Zahlen ein Dashboard erreichen.

  2. Nachvollziehbar – vom Dashboard zurück zur Quelle

    OpenLineage und dbt-Docs erfassen jede Transformation – kein verwaistes SQL, keine Schatten-Pipelines –, sodass Prüfer die Frage «Woher kommt diese Zahl?» in Minuten beantworten, nicht in Wochen. PII wird bei der Ingestion getaggt, DSGVO-Löschworkflows sind eingebaut, jeder Lese- und Schreibzugriff auf regulierte Daten wird protokolliert: Compliance ist eine Eigenschaft der Pipeline, kein separater Audit-Schritt.

  3. Konsistent & aktuell – eine Definition, produktionsreife Auslieferung

    Kennzahlen leben in einem Semantic Layer unter klarer Governance (dbt metrics, Cube, LookML) – Finanzen, Marketing und Betrieb greifen auf dieselbe Definition zu, und die Debatte «welche Zahl stimmt?» hat ein Ende. Dashboards laufen mit Freshness-SLAs und Performance-Budgets und werden wie produktive Services überwacht – niemand entscheidet auf Basis still veralteter Zahlen.

KI in der Pipeline

Wie KI verlässliche Daten-Pipelines beschleunigt

Produktive Daten-Pipelines brauchen mehr als Tempo – sie müssen verlässlich und nachvollziehbar sein und einer Prüfung standhalten. Unsere AI-augmented Delivery hilft Data Engineers, schneller zu arbeiten: KI-gestütztes SQL-Review, Schema-Validierung, Anomalieerkennung und automatisierte Prüfungen – während definierte Autonomiestufen (L1 Assisted – L4 Autonomous) die menschliche Aufsicht am Risiko jeder Aufgabe ausrichten.

Das wirkt in beide Richtungen. Wir setzen KI ein, um Daten-Pipelines sicherer und effizienter zu machen, und bauen zugleich die sauberen, versionierten und governance-konformen Datengrundlagen, auf die KI-Produkte angewiesen sind. Für Teams, die KI-Fähigkeiten aufbauen, liefern unsere Data-Engineering-Leistungen die Grundlage für Modelltraining, Feature Stores, RAG-Pipelines und produktive AI-Systeme.

Bauen Sie KI auf dieser Datengrundlage auf — AI Product Development

Kennzahlendefinition + Semantic Layer

KI hilft, Kennzahlendefinitionen zu entwerfen, doppelte KPIs zu erkennen und Strukturen für den Semantic Layer (dbt metrics, Cube, LookML) vorzuschlagen.

Analytics Lead und Business Owner bestätigen die Metrik-Semantik vor dem Merge in den Semantic Layer

Generierung von Pipeline-Tests

Great-Expectations- und dbt-Testfälle werden aus Data Contracts generiert; ein Engineer prüft die Abdeckung der kritischen Pfade.

Data Engineer validiert die Abdeckung; der SLA Owner gibt vor dem Release frei.

Unterstützung beim SQL-/dbt-Review

KI prüft SQL-Transformationen vor dem Merge auf Performance, Korrektheit und Stil. Häufige Antipatterns werden markiert.

Senior Engineer und dbt-CODEOWNER geben vor dem Merge frei – AI-Hinweise führen nicht automatisch zum Merge.

Erkennung von Schema-Drift

KI überwacht Quell-Schemata auf Breaking Changes; Engineers werden informiert, bevor nachgelagerte Pipelines brechen.

Engineer triagiert Drift; nachgelagerte Konsumenten werden informiert und geben den Behebungsplan frei.

Anomalieerkennung in der Datenqualität

KI überwacht Aktualität, Zeilenzahlen und Verteilungsverschiebungen über einfache Schwellenwert-Alarme hinaus. Muster, die Datenqualitätsvorfällen vorausgehen, werden früh sichtbar.

Der Pikett-Engineer triagiert Anomalie-Alerts; die Schwellenwerte werden monatlich mit dem Analytics Lead justiert.

Dashboard-Aktualität + Lineage

Freshness-SLAs für Dashboards werden überwacht; KI meldet veraltete oder defekte Visualisierungen, bevor sie in einem Review-Meeting landen.

Der Analytics Owner bestätigt den Schweregrad vor der Eskalation an Stakeholder; fehlerhafte Visualisierungen werden als Tickets wiedereröffnet.

AI-AUGMENTED DELIVERY

Data-Engineering-Grundlagen, verstärkt durch KI

Unsere Praxis der AI-augmented Delivery verbessert, wie wir Datenplattformen bauen und betreiben – KI-gestützte Pipeline-Entwicklung, SQL- und dbt-Review sowie Anomalieerkennung in der Datenqualität, aufgesetzt auf die oben beschriebenen Engineering-Standards. Die Grundlagen ändern sich nicht; KI macht sie schneller – und Engineers verantworten jede Änderung, die ausgeliefert wird.

Unser Vorgehen ansehen
Anwendungsfälle

Daten-Anwendungsfälle, die wir umsetzen

Die meiste Datenarbeit folgt einer Handvoll wiederkehrender Muster. Das sind jene, bei denen sich unsere Pipelines, Warehouses und Orchestrierungs-Stacks am schnellsten auszahlen.

ML Feature Stores & KI-fähige Daten

ML Feature Stores & KI-fähige Daten

Saubere, versionierte, reproduzierbare Features für ML- und LLM-Workloads. Beseitigt den Engpass «Data Scientists verbringen 80% ihrer Zeit mit Datenaufbereitung».

Feast / Tecton + Snowflake + dbt + vector DB (Pinecone, pgvector).

Customer Analytics & 360-Grad-Sicht

Customer Analytics & 360-Grad-Sicht

Kundenereignisse aus CRM, Produkt, Billing und Support zu einer einzigen verlässlichen Quelle zusammenführen. Grundlage für Segmentierung, Churn-Modellierung, Lifetime Value und Attribution.

Snowflake / BigQuery + dbt + Fivetran / Airbyte + Segment.

Dedicated development services we deliver

Regulatorisches und Compliance-Reporting

Quartals- und Ad-hoc-Reporting für Basel III, IFRS 9/17, Solvency II und DSGVO-Anfragen betroffener Personen automatisieren. Audit-Trails, Lineage und Reproduzierbarkeit sind eingebaut.

dbt + Great Expectations + Airflow + Snowflake / Databricks.

Dedicated development services we deliver

Regulatorisches und Compliance-Reporting

Streaming-Pipelines, die Transaktionen oder Verhalten in Sekunden bewerten statt im nächtlichen Batch. Feature Engineering, Model Serving, Alert-Routing.

Kafka + Flink / Spark Streaming + feature store + ML model API.

IoT- & Telemetrie-Pipelines

IoT- & Telemetrie-Pipelines

Sensor-, Geräte- oder Produkttelemetrie im grossen Massstab aufnehmen. Zeitreihenspeicherung, Anomalieerkennung, Dashboards für Ops-Teams.

Kafka + TimescaleDB / InfluxDB + Spark + Grafana.

Data Engineering & Analytics Services — Icon

Enterprise- & Big-Data-Engineering-Leistungen

Im Enterprise-Massstab verändern Volumen und Parallelität die Architektur: Streaming mit hohem Durchsatz, Warehouses im Petabyte-Bereich, Governance über mehrere Regionen. Genau hier zählt Beratung im Enterprise Data Engineering am meisten – einen Plattform-Neubau so zu takten, dass das Geschäft nicht stillsteht.

Wo wir liefern

Wo anspruchsvolle Datenarbeit entsteht

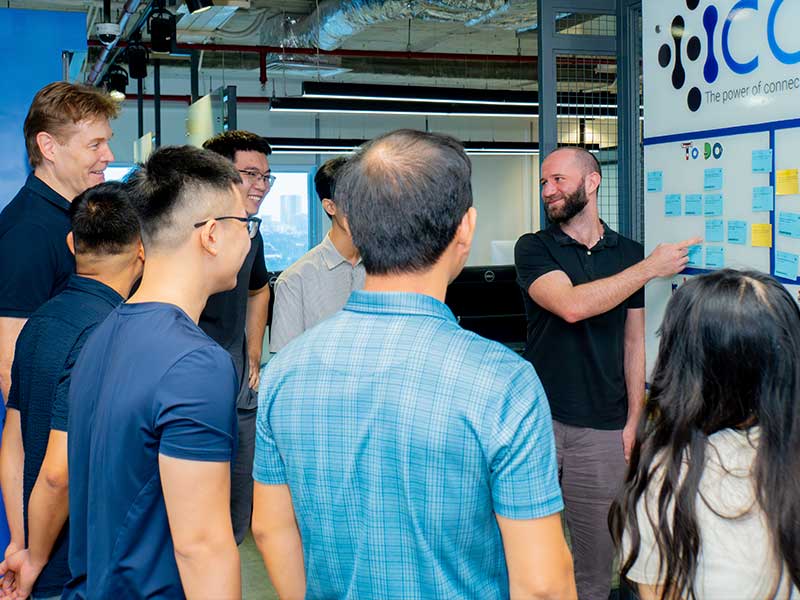
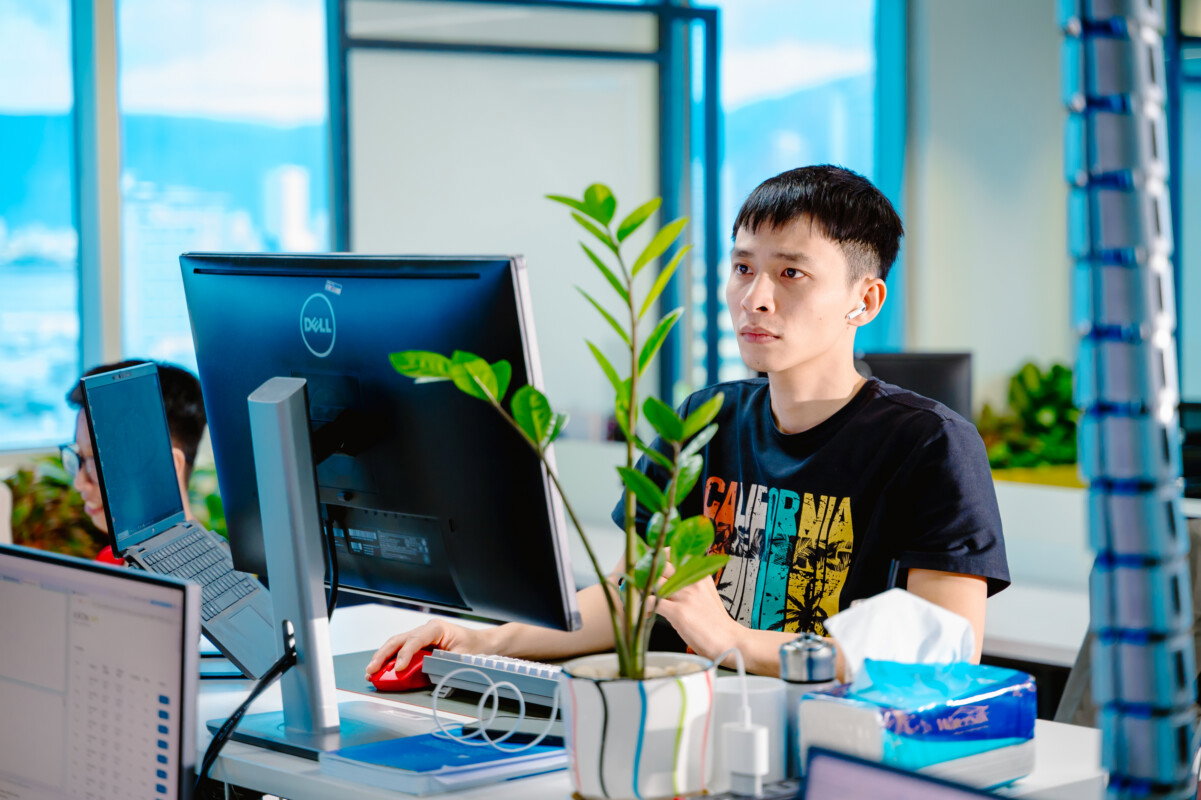
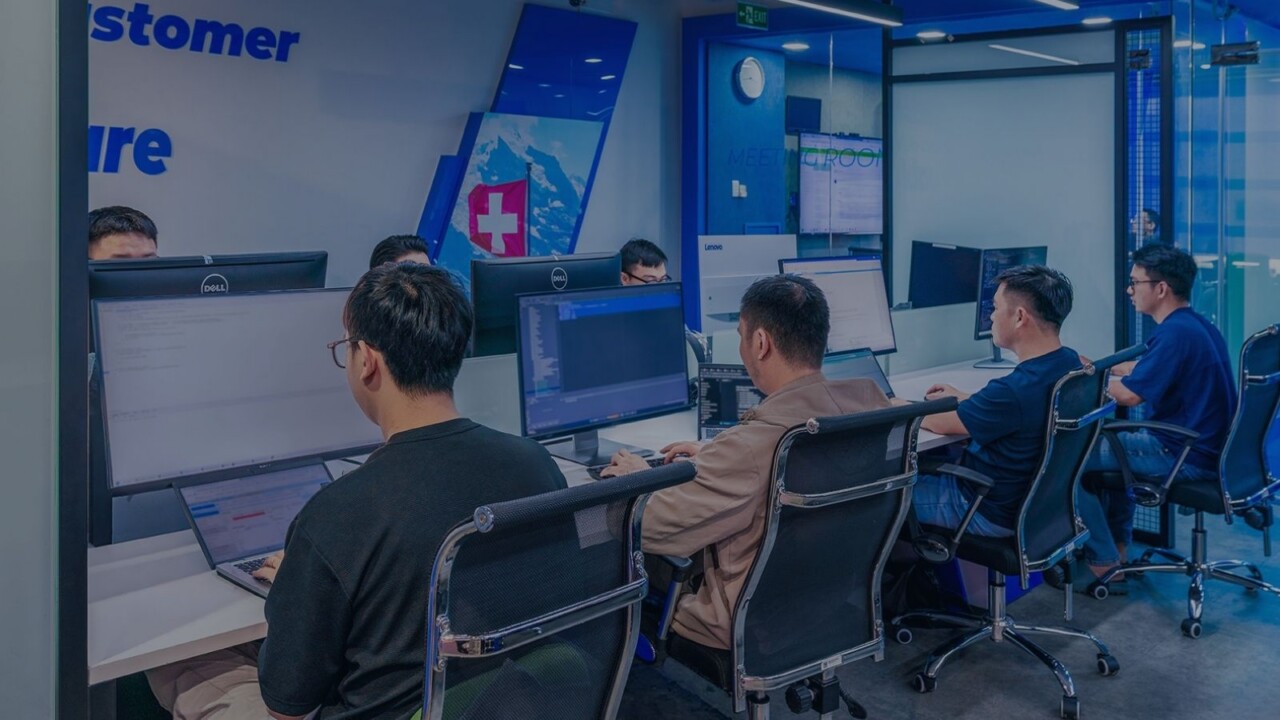
Hinter jeder Pipeline steht ein Team, das Ihre Daten kennt – und wir kennen unser Team. Data Engineers und Analysten arbeiten Seite an Seite in unseren vier Büros in Vietnam, an produktiven Datenplattformen für Kunden weltweit.

Data Engineering & Analytics at Axon Active — Where deep data work gets built
Data Engineer bei der Entwicklung von Daten-Pipelines und Verarbeitungs-Workflows
Cloud migration services for enterprise DevOps and cloud infrastructure
Data-Engineering-Team bei der Durchsicht der Datenarchitektur
Data Engineering & Analytics at Axon Active — Where deep data work gets built
Data-Engineering-Team bei der gemeinsamen Arbeit im Büro
SECURITY & COMPLIANCE

Jedes Engagement läuft unter unserem nach ISO/IEC 27001:2022 zertifizierten ISMS

NDA-, AVV- und SCC-Vorlagen liegen bereit, bevor Sie unterschreiben. 100% des geistigen Eigentums gehen an Sie über. Seit 2018 durchgehend nach ISO/IEC 27001 zertifiziert – aktuell nach der Fassung 2022, seit 2021 zertifiziert durch TÜV Rheinland – 13 externe Vor-Ort-Audits, 100% Bestehensquote.

Details ansehen
Stimmen unserer Partner

Von den Menschen, mit denen wir gemeinsam entwickeln

Mr. Shahar Cohen
Director of Engineering, WSC Sports

Seit über vier Jahren ist Axon Active eine verlässliche Erweiterung unserer Engineering-Organisation. Der Recruiting-Prozess ist effizient, die Kommunikation ausgezeichnet, und die Engineers finden sich durchwegs schnell zurecht und liefern Wert. Das Engagement sowohl für den Erfolg der Kunden als auch für die Entwicklung der Engineers macht Axon Active zu einem Partner, den ich sehr empfehle.

FAQ

Häufig gestellte Fragen

Worin unterscheiden sich Data-Engineering-Leistungen und Data-Analytics-Lösungen?

Zwei Hälften derselben Fähigkeit – Engineering baut und betreibt die Pipelines, Warehouses und die Governance darunter; Analytics beantwortet die Geschäftsfragen darüber. Wir liefern beides mit einem Team, damit die Zahlen, auf die Sie reagieren, immer auf Daten unter klarer Governance zurückführbar sind.

Wie verhindern Ihre Datenmigrations-Leistungen, dass das Reporting beim Cutover bricht?

Jede Migration läuft mit Parallel-Run-Validierung: Die neue Plattform liefert dieselben Zahlen wie die alte, nebeneinander, bevor jemand umschaltet. Der Cutover wird entlang Ihres Reporting- und Audit-Kalenders getaktet, mit bereitstehendem Rollback – damit die Finanzabteilung ihren Abschluss termingerecht macht, ob die Migration nun früher oder später fertig wird.

Wie gehen Sie mit Datenresidenz und grenzüberschreitenden Datenflüssen um?

Datenresidenz ist oft die eigentliche Randbedingung, nicht nur Compliance-Papierkram. Für EU-Kunden bleiben die Daten in EU-Regionen (typischerweise AWS Frankfurt, Azure West Europe, GCP Belgien) und werden ausschliesslich in der EU verarbeitet. Für Schweizer Kunden mit DSG-Anforderungen unterstützen wir Schweizer Cloud-Regionen oder den Betrieb on-premise, je nach Datenklassifizierung. Grenzüberschreitende Übermittlungen – wenn sie für unsere Delivery-Teams in Vietnam nötig sind – erfolgen ausschliesslich mit pseudonymisierten oder anonymisierten Testdaten; Produktivdaten verlassen Ihre Region nie. Wir erfassen die Datenflüsse im Discovery, klassifizieren jeden Datenbestand (öffentlich, intern, vertraulich, streng vertraulich) und entwerfen die Pipelines entsprechend. Die prüfbare Spur zählt ebenso viel wie das technische Setup – Ihr Compliance-Team muss Prüfern genau zeigen können, welche Daten wohin geflossen sind.

Build oder Buy – wie beraten Sie bei Warehouse-, Orchestrierungs- und BI-Werkzeugen?

Der Normalfall bei Daten-Werkzeugen ist Over-Buying: Anbieter kalkulieren aggressiv, und 6 bis 8 SaaS-Tools sind schnell gestapelt. Unser Rat geht in die andere Richtung – kaufen Sie dort, wo der Markt reif und standardisiert ist, und bauen Sie dort, wo Ihre Geschäftslogik sitzt. Beim Warehousing gewinnen Snowflake, BigQuery oder Databricks meist gegen den Eigenbetrieb, ausser Datensouveränität erzwingt on-premise. Bei der Orchestrierung sind Airflow, dbt oder Prefect reif genug – bauen Sie keinen eigenen DAG-Runner. Bei BI decken Looker, Metabase oder Power BI 90% des Bedarfs ab. Entscheidend wird die Frage bei der Transformationslogik und bei Reverse-ETL-Mustern – dort steckt Ihr Wettbewerbsvorteil, und dort sollten Sie nicht von einem Anbieter abhängen. Wir helfen Ihnen, diese Grenze zu ziehen, statt Ihnen einen Anbieter zu verkaufen.
Echtzeit-Streaming oder Batch – wann zahlt sich was aus?

Die meisten Teams bauen für Echtzeit über den Bedarf hinaus. Batch ist günstiger, leichter zu debuggen und für rund 80% der Geschäftsfälle ausreichend – ein täglicher oder stündlicher Refresh deckt die meisten Reportings, ML-Trainings und operativen Dashboards ab. Echtzeit-Streaming zahlt sich in bestimmten Szenarien aus: Betrugserkennung (Reaktion im Sekundenbruchteil), operatives Alerting (wenn Minuten zählen), Personalisierung für Nutzer (Empfehlungen, die mitten in der Sitzung aktualisiert werden) und ereignisgetriebene Geschäftslogik (Bestand, Preise, Benachrichtigungen). Die Kosten sind real – Streaming-Infrastruktur wie Kafka, Flink oder Kinesis ist teurer im Betrieb, im Personal und im Debugging als Batch-Pipelines. Unsere Standardfrage an Kunden: Was kostet es das Geschäft, wenn die Daten eine Stunde alt sind? Lautet die Antwort «nichts Wesentliches», gewinnt Batch.

Wie stehen Sie im Vergleich zu Beratungsfirmen für Data Analytics da?

Die meisten Beratungsfirmen für Data Analytics beraten, bauen aber nicht – und wenn ein Data-Engineering-Beratungshaus die Umsetzung weitervergibt, wechselt die Verantwortung mitten im Engagement. Wir machen beides im eigenen Haus: Die Berater, die die Architektur empfehlen, sind die Engineers, die sie bauen und betreiben.

Bieten Sie Data Engineering as a Service an oder nur Projektumsetzungen?

Beides. Wir bieten Data Engineering as a Service – ein fest zugeordnetes Team, das Ihre Plattform Monat für Monat betreibt – sowie Umsetzungen mit festem Scope und Data Engineering & Analytics Consulting für einzelne Architekturentscheidungen.

Wie beginnt ein Engagement mit Axon Active?

Mit einem ersten Gespräch. Wir hören zu: Was bauen Sie, was brauchen Sie, was erwarten Sie? Wir zeigen Ihnen, was wir anbieten, und schlagen einen Teamzuschnitt, einen Zeitplan und ein Preismodell vor. Kein Foliensatz, kein Verkaufsskript. Passen wir nicht, sagen wir es Ihnen. Passen wir, gehen wir in die Vertragsgespräche und starten Recruiting und Onboarding.